Votre IA locale, sans acheter de GPU
Un vrai PC Windows dans le cloud, avec un GPU RTX dédié, disponible dès que vous en avez besoin.
Voir les offres- Ollama et LM Studio en natif
- GPU NVIDIA RTX dédié
- Vos modèles restent sur votre disque
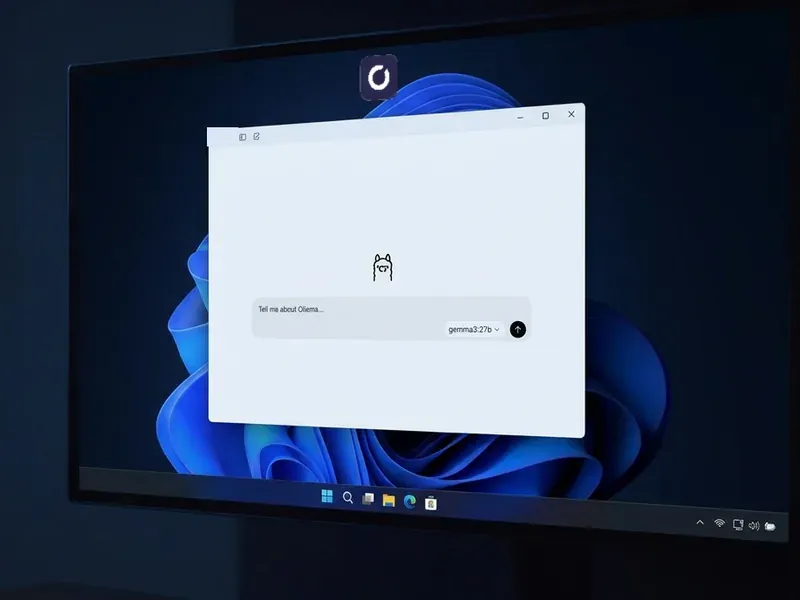
Sur un Shadow PC, une IA locale s'installe exactement comme sur une tour posée sous votre bureau. Vous téléchargez Ollama ou LM Studio depuis leur site, vous récupérez un modèle quantifié, et il répond sur le GPU. Le fichier du modèle est sur votre disque et il y reste d'une session à l'autre. Aucun fournisseur de modèle ne voit vos prompts, et rien n'est facturé au token.
Tout se joue sur le GPU. Un modèle 7B demande environ 6 Go de VRAM en 4 bits une fois un contexte de travail chargé, un 14B plutôt 12 Go, et la plupart des portables s'arrêtent bien avant le second chiffre.
Ce que vous faites tourner en local, et à quelle vitesse
Un modèle 7B quantifié en 4 bits occupe environ 5 Go pour ses poids, un 8B un peu plus, un 14B environ 9 Go, et le contexte chargé s'ajoute par-dessus : comptez plutôt 6 Go et 12 Go en usage réel. Chaque rallonge de contexte se prend sur la même enveloppe. C'est ce calcul qui décide si une IA locale répond du tac au tac ou devient inutilisable, et c'est pour ça que le même modèle n'a rien à voir d'une machine à l'autre.
Voici ce qu'un Shadow PC met dans la balance. Power et Power Pro embarquent 20 Go de VRAM dédiée et 28 Go de RAM, et la page Offres fixe le plafond à 32B, en quantification Q3 à Q4. Cela couvre l'inférence et le LoRA léger. Pas l'entraînement de vos propres modèles à partir de zéro.
Côté vitesse, Qwen3.5 9B tourne à 29 tokens par seconde sur Neo Pro et GPT-OSS 20B à 59 ; sur Power Pro, c'est 74 et 133. Whisper Medium transcrit 9 à 11 fois plus vite que le temps réel. Ce sont les chiffres publiés sur notre page Offres, modèles de langage en quantification Q4_K_M, et les résultats peuvent varier selon les mises à jour et les pilotes.
Neo Pro
Vitesse mesurée
- Qwen3.5 9B29 t/s
- Gemma4 e4b45 t/s
- GPT-OSS 20B59 t/s
- Whisper Medium9× le temps réel
Power Pro
Vitesse mesurée, avec 20 Go de VRAM et 28 Go de RAM
- Qwen3.5 9B74 t/s
- Gemma4 e4b97 t/s
- GPT-OSS 20B133 t/s
- Whisper Medium11× le temps réel
Ce qui tient en VRAM
Besoins approximatifs en quantisation 4 bits
- Modèle 7Benviron 6 Go
- Modèle 14Benviron 12 Go
- Le plus gros sur Shadow PCjusqu'à 32B, Q3 à Q4
Vitesses publiées sur la page des offres Shadow PC, quantisation Q4_K_M. Les résultats peuvent varier selon les mises à jour et les pilotes. Chaque gigaoctet de contexte se prend sur le même budget de VRAM.
Trois étapes jusqu'à votre premier modèle
-
Ouvrez votre Shadow PC. Depuis un Mac, un portable Windows, un iPad, un Chromebook ou le navigateur. Vous arrivez sur votre propre bureau Windows 11, avec un GPU RTX dédié derrière.
-
Installez Ollama ou LM Studio. L'installeur Windows habituel, depuis le site officiel. Pas de conteneur, pas d'acrobaties en ligne de commande. LM Studio vous donne un catalogue de modèles et une fenêtre de chat. Ollama, une application locale et une API sur localhost.
-
Récupérez un modèle et lancez-le.
ollama run qwen3.5:9btélécharge quelques gigaoctets sur une connexion à 1 Gb/s et commence à répondre. À la connexion suivante, le modèle est toujours là. Vous ne le téléchargez pas deux fois.
Ce que local veut dire ici
La plupart des guides emploient le mot au sens de « sur la machine posée dans mon salon ». Il recouvre pourtant deux choses différentes.
La première tient à qui se trouve entre vous et le modèle : aucun fournisseur ne voit vos prompts, pas de clé d'API, pas de compteur de tokens. Un Shadow PC vous la donne en entier. Les poids du modèle sont des fichiers sur votre disque, vous choisissez le modèle, la quantification et l'interface, et vos contenus ne sont jamais utilisés par Shadow pour entraîner des modèles. Nous n'avons pas accès à vos prompts.
La seconde tient à l'endroit où se trouve le matériel. Un Shadow PC est un ordinateur auquel vous accédez par internet : il lui faut une connexion, et vos données sont dans notre datacenter. Pour travailler sans aucune connexion, il faut du matériel sur votre bureau. Si ce qui compte, c'est la confidentialité, le contrôle et le coût, un Shadow PC coche les trois cases.
Vos modèles restent là où vous les avez mis
Louez un GPU à l'heure et le compteur démarre avant le modèle : un modèle 32B, c'est un téléchargement d'environ 20 Go facturé à la minute, et à moins d'avoir payé pour conserver le volume, vous retéléchargez tout la semaine suivante.
Un Shadow PC est une machine avec un disque, extensible jusqu'à 5 To, et ce que vous installez reste installé : votre bibliothèque de modèles, vos préréglages LM Studio, votre environnement Python. Vous payez au mois, donc un long téléchargement ne vous coûte rien de plus.
Une limite : le PC s'éteint après une période d'inactivité et à la fin d'une session, même si quelque chose tourne encore. Pour les traitements longs, la gamme Shadow PC Pro propose l'option payante Always On.
Acheter, louer à l'heure, ou s'abonner
Trois façons de mettre un GPU derrière un modèle local, et chacune a son point faible. Acheter une carte est la seule voie qui fonctionne sans aucune connexion. C'est aussi celle qui se paie d'un coup, exige une tour pour accueillir la carte et vous laisse du matériel qui vieillit. Louer un GPU à l'heure est la solution la moins chère pour lancer quelque chose une fois, et la pire pour le faire régulièrement : le compteur tourne pendant le téléchargement, le stockage est facturé à part, et rien de ce que vous installez ne survit si vous ne payez pas pour garder le volume. L'abonnement à un PC Windows complet est la voie du milieu : un coût fixe et un disque qui garde vos modèles. Et la même machine fait tourner vos jeux quand elle ne fait pas d'inférence.
| Shadow PC | Acheter une carte | GPU à l'heure | |
|---|---|---|---|
| Fonctionne sans aucune connexion |
Shadow PC
Non disponible
|
Acheter une carte
Disponible
|
GPU à l'heure
Non disponible
|
| Paiement initial |
Shadow PC
Aucun
|
Acheter une carte
Payé en entier d'avance
|
GPU à l'heure
Aucun
|
| Facturation |
Shadow PC
Au mois, fixe
|
Acheter une carte
En une fois
|
GPU à l'heure
À l'heure, au compteur
|
| Télécharger un gros modèle |
Shadow PC
Compris dans le mois
|
Acheter une carte
Sur votre propre connexion
|
GPU à l'heure
Facturé pendant qu'il tourne
|
| Les modèles restent installés |
Shadow PC
Disponible
|
Acheter une carte
Disponible
|
GPU à l'heure
Seulement avec un volume payant
|
| Stockage |
Shadow PC
Inclus, extensible en option jusqu'à 5 To
|
Acheter une carte
Vos propres disques
|
GPU à l'heure
Facturé à part
|
| Bureau Windows complet, pour vos autres logiciels et vos jeux |
Shadow PC
Disponible
|
Acheter une carte
Disponible
|
GPU à l'heure
Conteneurs et ligne de commande
|
| Tourne jour et nuit |
Shadow PC
Avec l'option payante Always On, gamme Pro
|
Acheter une carte
Disponible
|
GPU à l'heure
Disponible
|
Le GPU à l'heure désigne les services de location de GPU facturés à l'heure, tels que décrits sur leurs pages de tarifs en septembre 2026. Aucun montant n'est affiché : ils varient selon le marché et changent souvent.
Quel Shadow PC pour une IA locale
Power et Power Pro affichent 20 Go de VRAM dédiée et 28 Go de RAM, et la page Offres annonce pour Power jusqu'à 50 % de puissance GPU de plus que Neo. La gamme Pro ajoute l'option payante Always On, pour les traitements qui doivent continuer sans vous.
Le GPU que votre Mac n'a jamais eu
Un visiteur sur six de nos pages IA est sur Mac. Les puces Apple font tourner correctement les petits modèles, puis butent sur tout ce qui réclame CUDA, et une bonne partie de l'outillage suppose encore une carte NVIDIA.
Un Shadow PC est une deuxième machine qui, elle, a la carte, et vous y accédez depuis celle que vous avez déjà : un MacBook Air, un portable professionnel verrouillé, un ultraportable. Vous faites tourner un 14B depuis votre canapé, et les ventilateurs qui s'emballent ne sont pas les vôtres.
Votre propre carte reste libre pour vos jeux. Et comme un Shadow PC est une machine Windows 11 ordinaire, il fait aussi tourner des jeux quand il ne fait pas tourner de modèle : Ollama s'installe à côté de Steam, pas à sa place.
Questions sur l'IA locale
Oui, au sens qui compte. Une IA locale n'a pas de compteur d'API : une fois le modèle sur votre disque, vous générez autant de tokens que vous voulez, sans facturation au million. Les vraies limites sont la machine et votre temps. Un gros modèle répond plus lentement, un contexte long consomme plus de mémoire, et sur Shadow PC le quota mensuel (fair use) est de 120 heures sur Shadow PC Lite et de 210 heures sur Shadow PC et Shadow PC Pro.
Pour un modèle 7B quantifié en 4 bits, 6 Go de VRAM passent tout juste, avec un contexte court et rien d'autre sur la carte. C'est aussi la configuration qui donne la pire image des modèles locaux. À partir de 8B, il faut de la marge, et un 14B occupe environ 9 Go pour ses poids, plutôt 12 Go avec un contexte utile. Shadow PC Power et Power Pro embarquent 20 Go de VRAM dédiée, de quoi loger un 14B avec un long contexte.
La page Offres fixe le plafond à 32B, en quantification Q3 à Q4 ; ce sont les 20 Go de VRAM de Power et Power Pro qui permettent d'y aller. En dessous, tous les modèles de nos benchmarks publiés tournent : Qwen3.5 9B, Gemma4 e4b et GPT-OSS 20B, tout comme le palier 14B avec un long contexte. Comme le PC est une machine Windows ordinaire, le catalogue est celui d'Ollama, de LM Studio ou de Hugging Face, pas une liste que quelqu'un a choisie pour vous.
Trois raisons reviennent sans cesse. Le coût : une API facture chaque token, un modèle local ne coûte plus rien après le téléchargement. Le contrôle : vous choisissez le modèle et la quantification, et aucun fournisseur ne les modifie ni ne les retire du jour au lendemain. Les données : vos prompts et vos documents ne passent par aucun fournisseur de modèle. La vitesse n'entre presque jamais en jeu : un modèle de pointe hébergé est en général plus rapide que ce que vous faites tourner vous-même.
Non. Un Shadow PC est un ordinateur auquel vous accédez par internet : il lui faut une connexion, et le modèle tourne là-bas, pas sur l'appareil posé devant vous. Vos prompts ne passent toujours par aucun fournisseur de modèle et les poids restent sur votre disque, mais le hors-ligne, un PC dans le cloud ne peut pas l'offrir. Si vous devez travailler sans aucune connexion, il vous faut du matériel local.
Pas indéfiniment. Un Shadow PC s'éteint après une période d'inactivité et à la fin d'une session, même si un programme tourne encore : un traitement long laissé sans surveillance sera donc interrompu. L'option payante Always On de la gamme Shadow PC Pro existe pour ça : elle maintient la machine allumée pour qu'un traitement ou un agent continue pendant votre absence. Sur les autres gammes, prévoyez des traitements qui tiennent dans une session.
La RAM système compte moins que la VRAM, mais elle compte. Réservez 8 Go pour Windows et vos applications habituelles, puis comptez que le chargeur de modèle garde une partie des poids en RAM pendant qu'il alimente le GPU. En pratique, 16 Go suffisent pour du 7B et du 8B, et un peu plus de marge devient utile dès qu'on va au-delà ou qu'on ouvre une interface à côté. Shadow PC Power et Power Pro embarquent 28 Go, de quoi faire cohabiter le chargeur de modèle et votre navigateur.
Votre prochaine machine à IA tient dans un abonnement
Pas de carte à dénicher, pas de configuration à monter. Installez Ollama et votre premier modèle répond en quelques minutes.